
读到文字,不等于读到了图
处理带图表的 PDF,先确认任务依赖的是正文、表格还是图片。2026年10月17日核对的 Claude 官方上传说明写明:100页及以内的 PDF 可分析文字和视觉元素,101至1000页只处理文字,超过1000页无法上传;非 PDF 文档主要提取文字,其中嵌入的图片不会被读取。能力边界可能更新,使用时应核对文末原文和实际提示。
因此,向一份长 PDF 询问图表细节时,不能只看它是否给出流畅回答。先让它定位目标页和图表标题,并确认当前材料中是否包含可读取的图。本文没有用真实账户测试任意 PDF,下面给的是可自行执行的检查方法。
页码先记录两个编号
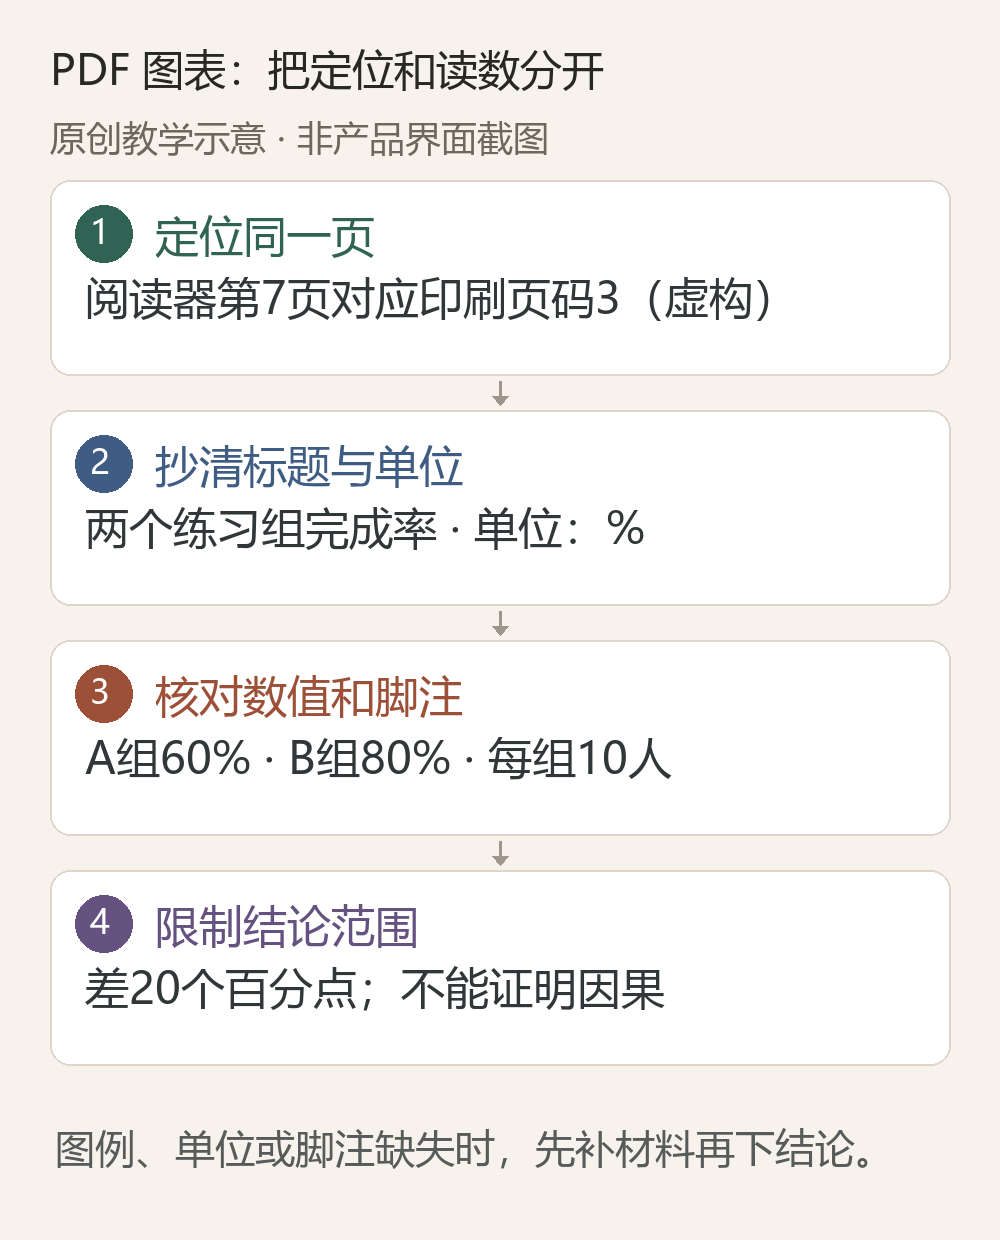
官方建议引用 PDF 阅读器显示的页码。若文件前面有封面和目录,印刷页码“3”可能实际位于阅读器第7页。给模型的任务里写清“阅读器第7页,印刷页码3”,不要在不同编号之间来回切换。拆分文件后,再保留原文件页码与新文件页码的对应关系。
虚构柱状图:60和80究竟表示什么
假设练习图标题为“两个练习组完成率”,纵轴单位是百分比,A组60%,B组80%,脚注说明每组各10人。这不是实际调查。模型可以根据图中数值描述B组高20个百分点,但不应写成“提高20%”,也不能据此声称某种工具导致了提升。
让它先输出标题、单位、图例、两组数值和脚注,再写一句结论。这样你能先检查读数是否正确,而不是在一大段分析里找出错的数字。图只显示完成率时,不要反推出未提供的成本、收入或整体用户规模。
看不清的地方要保留为空
如果图像过小,重新提供清晰的相关页或图表区域,并保留标题、坐标轴、图例和脚注。单独截取一根柱子可能丢失单位,反而更难判断。不要通过提示“大胆估计”把模糊数值变成精确数据;可以要求只描述趋势,并明确无法读出的标签。
对扫描件,优先人工抽查小数点、负号、百分号和千位分隔符。缺失值不是零,空白格也不一定表示没有发生。若一个表的单位在上一页,提供关联页后再分析;不要把分开的页当作彼此无关的材料。
长文档可以围绕目标页缩小任务
先列出你真正要回答的问题,再按章节拆出必要页面。拆分时保存来源、版本、原页码和必要上下文。文件变小只是处理手段,不能以缩减上下文为代价删掉适用条件。对照原文件检查关键页是否完整,再交给模型读取。
最后用原图核对所有影响结论的数字,并检查解释有没有超出材料。没有原始数据时,图表读取结果适合辅助定位,不应直接替代需要精确数值的原数据。若你的目标是提取文本表格,可继续阅读本站《Claude 表格信息提取教程:保留单位、空值与原始行号》。