
展示来源需要保留响应结构
API联网搜索回答不只是一段文字。响应还可能包含工具调用、搜索结果和带引用的text块;如果应用只取第一个content元素,可能既丢失答案,又丢失来源。
本篇面向实现前端展示的开发者,重点是把每段论断与引用对应起来,不提供实时排名或“全部资料已核验”的保证。它与用户手工点击网页来源的教程切入点不同。
先按内容块类型分流
按当前官方响应结构识别text块和工具相关块,保留它们的相对顺序及关联。给最终回答显示引用时,读取对应text.citations中的web_search_result_location,而不是把搜索结果列表第一条硬挂到所有段落。
web引用包含url、title、encrypted_index及cited_text等信息。多轮回传需要按官方协议保留相关引用数据,不自己重造encrypted_index,也不把它当成公开网页地址。
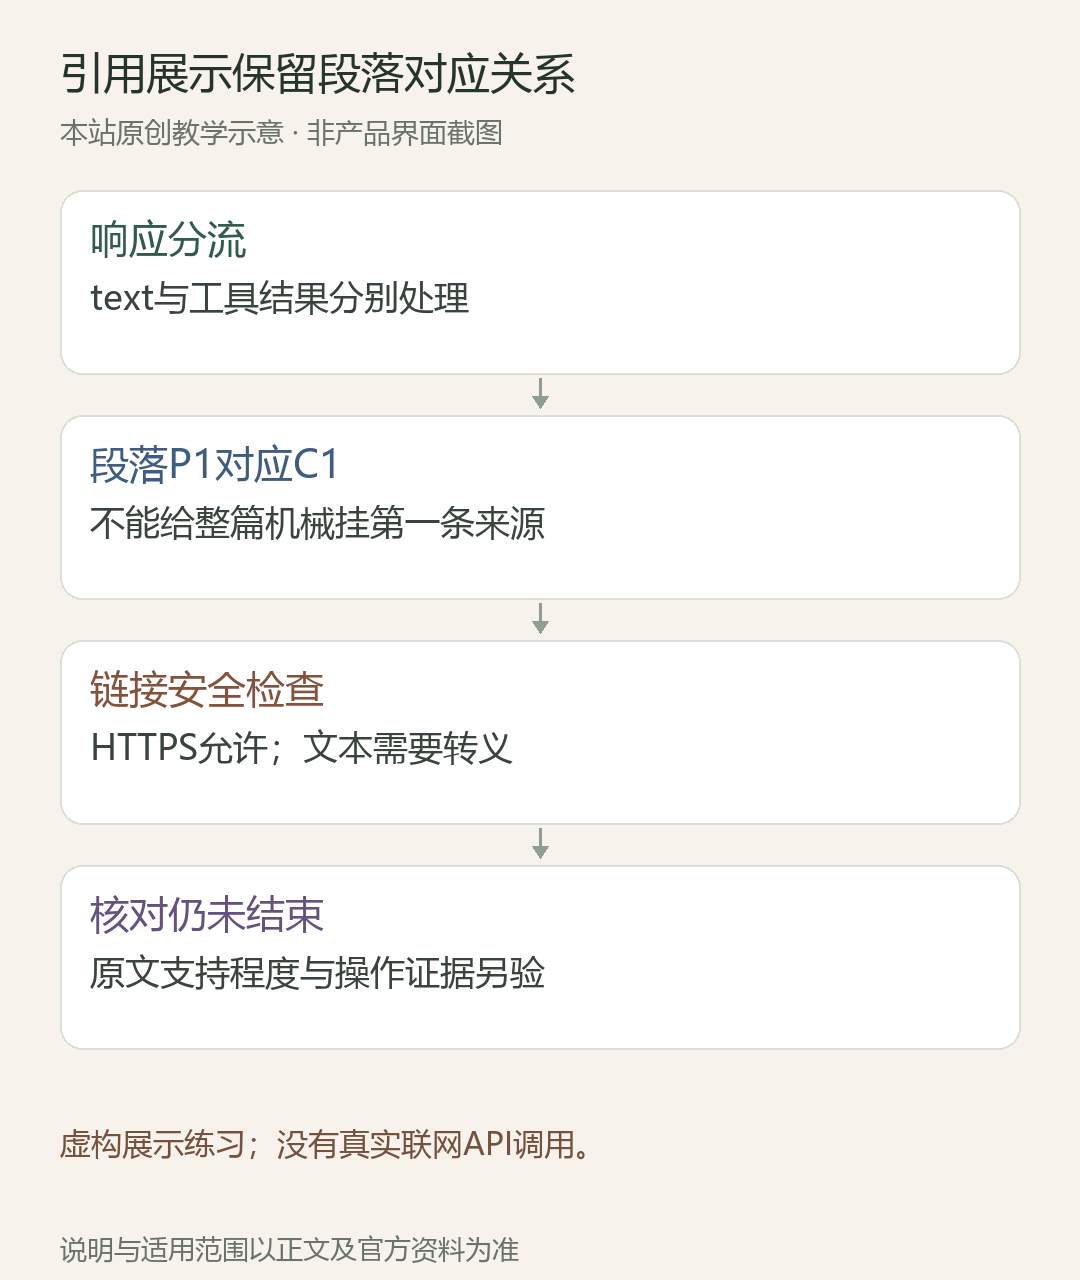
用一个虚构结果检查界面
假设段落P1说“产品文档列出了文件输入路径”,引用C1指向官方PDF支持页;段落P2说“本账户今天已成功上传”,却没有调用证据。P1可点开来源继续核对,P2不能借用C1宣称账户操作已经发生。
人工验收记录应包括段落编号、真实来源URL、引用片段与能支持的结论。显示“来源1”本身不等于事实核查完成,更不能用搜索摘要推断你的付费账户、权限或操作结果。
渲染链接前做哪些检查
只让页面使用允许的HTTPS地址,拒绝javascript等协议及含账号密码的URL;标题、片段和正文必须作为文本转义,不能把模型返回字符串直接塞成未过滤HTML。
同一URL可以在来源清单去重,但不能抹掉每个段落的引用归属。点击打开原文后核对发布日期、实际正文与适用条件;链接返回成功不保证它支持当前论断。
没有搜索与工具失败要分开
官方说明是否搜索与请求和模型判断有关。未发生搜索时不要显示“已联网核验”;工具返回错误时也不能只因整体HTTP为200就宣布检索成功,应检查工具结果及最终停止状态。
本篇没有真实联网API调用或费用测试。文末是展示层验收模板而非完整渲染组件。接入前应在测试页面构造安全链接、无引用、工具错误与恶意协议四类输入,确认不误报成功、不执行不安全链接。
参考资料与核验范围
资料核对日期:2026年10月19日。以下为官方原始资料;产品入口和可用范围仍以当前账户为准。
1. [官方资料1](https://platform.claude.com/docs/en/agents-and-tools/tool-use/web-search-tool)