
先看原始字节,别急着改提示词
中文流式输出夹着替换符,而非流式结果正常,可能是应用把每个网络分块独立解码了。UTF-8一个字符可能由多个字节组成,网络块边界不承诺与字符边界一致。
这发生在SSE事件解析之前:字节先解码成文本,文本再拼成事件,事件再解析JSON。本文只修第一层,不替代完整SSE读取器,也不把乱码一律归为模型问题。
把“你好”和表情故意切开
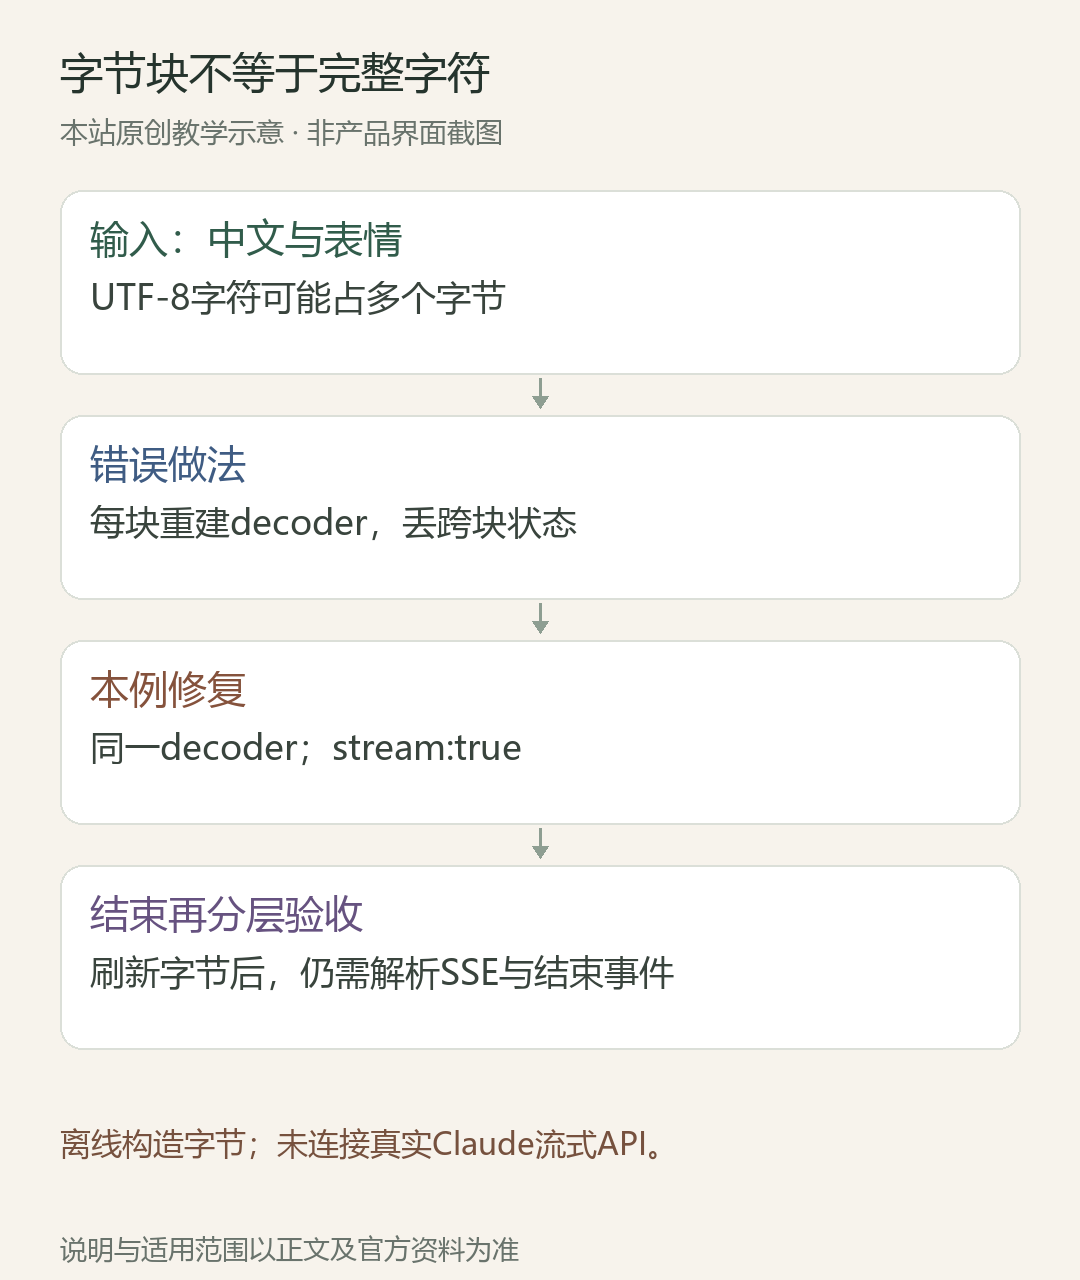
离线样例把“你好🙂”编码为UTF-8,再在字节1、4、8处切成四段,让中文与表情跨段。若每段都new TextDecoder后立即解码,未完成的字符会失去后续字节。
正确示例在同一条流中复用一个TextDecoder,每段decode时传stream:true,结束后再decode一次刷新。它保留尚未完成的字节序列,最终拼回原文。
运行并比较两条输出
将代码保存为utf8-chunk-decoder.mjs,用Node.js 24 LTS运行:node utf8-chunk-decoder.mjs --demo。correct应严格等于你好🙂;wrong显示独立解码产生的异常结果。
本例输入是TextEncoder制造的已知字节,不涉及真实HTTP、密钥或API费用。测试还把每一个字节单独作为一段,确认只要顺序与内容不变,状态解码能还原同一段文字。
为什么选择fatal而不悄悄替换
示例指定fatal:true,对真正非法的UTF-8或结束时不完整的序列抛错,方便区分数据损坏与正常跨块。默认替换模式可能继续显示替换符,这是一种错误处理策略,不代表解码结果完整可信。
捕获错误后保留脱敏的请求标识、阶段和截断信息,避免把半句话当成最终答案。不要自动把所有替换符删掉;删字符可能掩盖金额、编号和代码已经损坏。
接回实际流时注意三处边界
decoder应属于一次响应流,不要跨不同请求共用。取消或失败时不要将已有文本标成完整成功;流结束后刷新只检查字节是否完整,不能证明message_stop已经出现。
解码得到文本后,SSE仍可能半行、半事件或跨JSON。需要另一个缓冲层保留未完成文本;一块网络数据既可能含多个事件,也可能只有事件的一部分。本站已有流式事件文章讨论后续协议层,本篇不重复实现。
已测范围与排查下一步
本地测试通过单字节分块、空输入、非法字节拒绝和尾部截断拒绝。没有真实调用Claude流式端点,没有测试代理、压缩或生产网络故障,也没有测延迟。
如果正确解码后仍乱码,应进一步核对原始编码、代理变换和服务端响应,再看SSE与JSON解析。先确定哪一层第一次出现错误,才能把最小证据交给Claude修复。
参考资料与核验范围
资料核对日期:2026年10月20日。以下为官方原始资料;产品入口和可用范围仍以当前账户为准。
1. [官方资料1](https://platform.claude.com/docs/en/build-with-claude/streaming)
2. [官方资料2](https://nodejs.org/api/util.html#class-utiltextdecoder)