
字符数不是token数,计数也不是整张账单
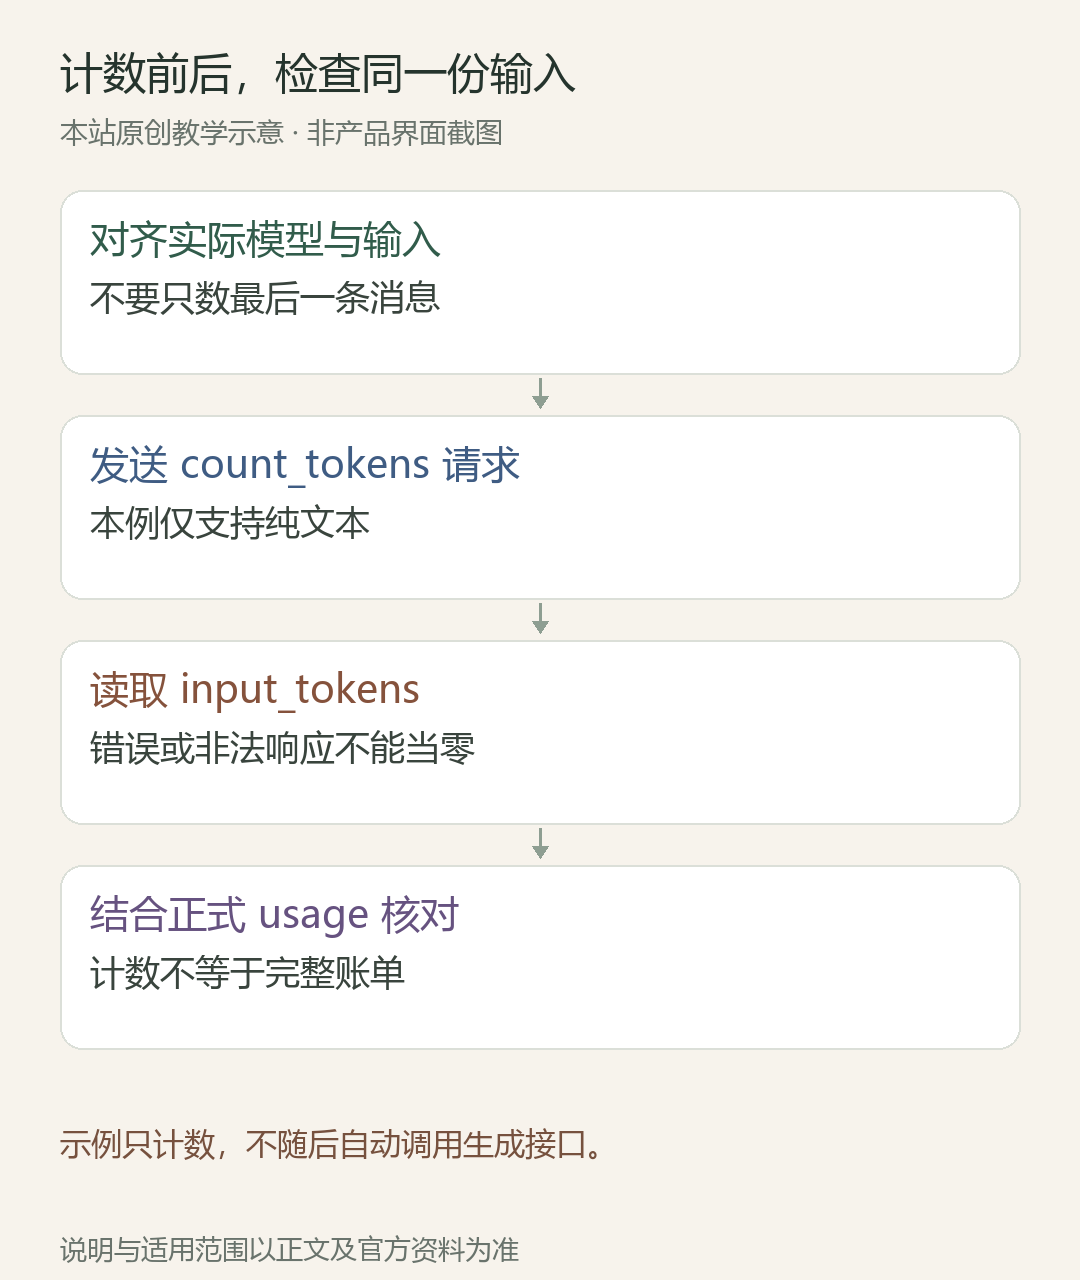
需要在Claude API请求前评估输入规模,可以使用Messages的count_tokens端点,提交与实际请求相匹配的模型和输入结构。不要把中文字数、文件大小或某次旧调用的比例当成所有输入通用的换算公式。
返回的input_tokens用于了解输入规模,不包括你还没生成的所有输出,也不自动等于最终费用。模型、缓存、工具和实际使用方式都可能影响计费判断,应继续查看正式响应中的usage和账户记录。
先明确你要检查哪一份输入
把system、messages以及相关输入项组织成与实际消息请求一致的结构。若计数时用一个模型、生成时用另一个模型,就应明确这个差异,而不是把结果宣称成后者的精确估算。
不要只计算最后一条user文本,却把实际调用中还携带的多轮历史漏掉。工具定义和附件也可能影响输入规模,测试前应确认计数端点当前支持的输入形式。
官方当前说明对某些服务端工具、MCP以及使用url或file来源的图像文档有额外限制;需要计数图像或PDF时,应按文档支持的形式准备。本篇只实现纯文本输入,不声称覆盖所有附件和工具场景。
最小纯文本例子怎样运行
文末提供count-input.mjs。准备Node.js 22或24 LTS版本,按首次调用教程设置ANTHROPIC_API_KEY和CLAUDE_MODEL;如果账户使用多工作区密钥,还需设置对应工作区变量。
将代码保存成该文件后执行node count-input.mjs。它向/v1/messages/count_tokens发送一个固定的原创短样例,并输出input_tokens;不会随后自动调用生成接口,也不会为了“验证计费”发起额外收费消息。
密钥由环境变量读取,不能把真实值贴进代码或文章评论。计数失败时先看实际HTTP状态与官方输入要求,不把错误结果按零处理。
用两份输入找到真正可以减少的部分
以下是原创练习:第一份请求带上完整的虚构任务说明;第二份只删去重复背景,保留任务、必要条件与证据。分别记录两次计数与具体差异,再判断删掉的是冗余,还是影响答案的关键材料。
计数更小不一定代表更好。若删去了来源和限制条件,答案可能更便宜却无法核对。正确目标是减少无信息增量的输入,而不是为了达到一个数字而把任务需要的上下文拿掉。
多轮任务还应检查历史增长:每次增加哪些消息,是否重复附加同一份资料,哪些内容可以根据实际需要重新检索。不要在没有验收的情况下让模型摘要替代唯一原件。
怎样验证这段代码
本站本地测试检查了端点路径、模型与messages字段、输入计数的解析,以及错误和非法响应不会被当成零。测试用的是构造的HTTP响应,不是从某个真实模型获得的token统计。
你自己的验收应记录模型ID、输入版本、计数结果和正式调用的usage,先理解差异再建立预算规则。若要换算费用,应另查当前模型与使用方式的官方价格,不能简单给input_tokens乘一个不明来源的常数。
计数应该放在业务的哪一步
适合在提交较大任务、比较输入版本或实施输入规模限制之前使用。它是一个需要独立处理超时与错误的请求,不应无限重试,也不应在失败时悄悄跳过你原本设置的限制。
文末示例没有实现缓存、复杂文件、服务端工具计数或完整的费用控制系统。只有相应功能确实接入并验收后,才应在交付说明里写成“已实现”。
参考资料与核验范围
资料核对日期:2026年10月18日。以下为官方原始资料;产品入口和可用范围仍以当前账户为准。
1. [官方资料1](https://platform.claude.com/docs/en/build-with-claude/token-counting)