
先读usage,不从回答速度猜命中
提示缓存是否命中,应检查具体响应的usage,而不是凭回答变快、文本相同或第二次调用成功推断。对这个端点的一条完整响应,先分开普通输入、缓存写入和缓存读取。
本文只解释顶层计数和一份离线对账表,不实现缓存配置器、不承诺降低某个账户的账单。调用前数token与调用后核对缓存是两个任务。
三项计数怎样相加
官方说明,在相应缓存usage中,input_tokens并非整份输入的总数;还要加上cache_creation_input_tokens和cache_read_input_tokens。先保留三项原值,再计算总输入,不能把总数又和读取量叠加一次。
遇到缺字段、负数、字符串或不同版本的响应,记录信息不完整。文末示例选择拒绝缺字段,避免把缺失默认为0而误报没有缓存;若你的SDK有默认值,应先确认该默认值的含义。
一份能手算的虚构记录
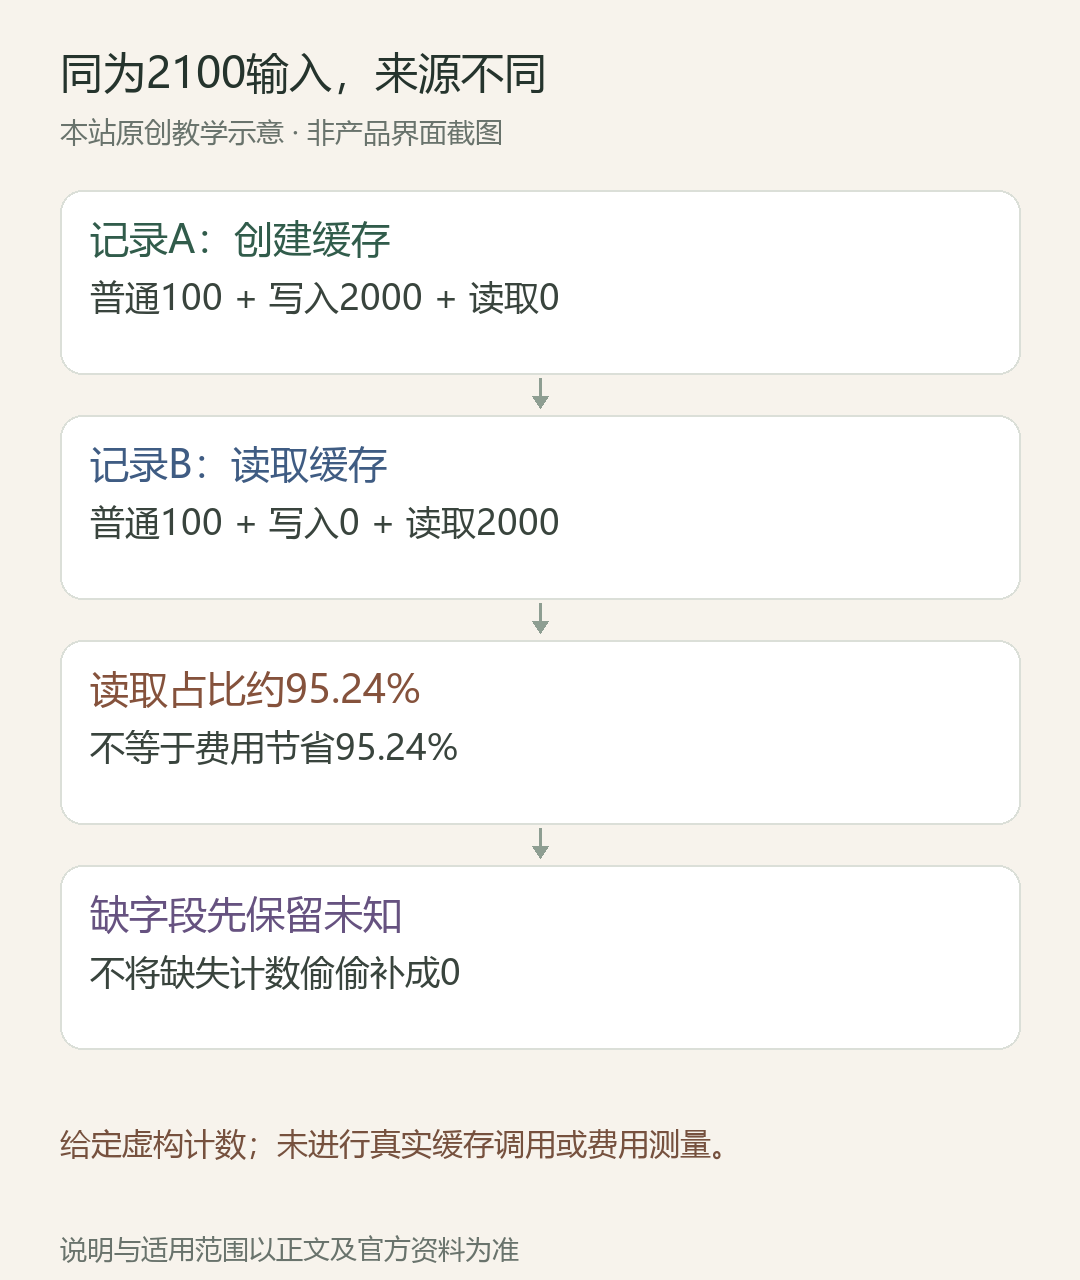
记录A:input_tokens=100,写入=2000,读取=0,总输入为2100。记录B:普通输入仍100,写入0,读取2000,总输入也为2100。A表示本例给定计数中有写入,B有读取,不是说B只处理100个输入token。
B的读取占比为2000÷2100,约95.24%。这不是省下95.24%的费用:读取、写入、普通输入和输出的计费方式需要按模型及实际服务核对,不能用一个占比直接替代账单。
把统计函数跑起来
将文末代码保存为cache-usage-check.mjs,用Node.js 22或24 LTS运行:node cache-usage-check.mjs --demo。前两行totalInput都应是2100,第二行readShare约0.95238;第三行只提供普通输入,返回valid:false。
本地函数只检查三项非负安全整数并求和,不发请求,不创建缓存,不测真实延迟。零总数时占比返回null;分母为零不能显示为100%命中。
读取量是0时按顺序检查
先确认是否真的配置缓存、输入是否满足当前模型的最小可缓存长度,再看可缓存前缀是否一致、缓存是否过期、请求是否在正确的账户/服务边界内。不同模型和平台条件可能变化,应回到对应官方段落核对。
用相同的受控输入版本记录请求时间、模型、三项usage和结果。不要把每次变化的时间戳、随机标识放进原本打算重复利用的前缀后,又单凭“语义差不多”声称应命中。
留下能对账的记录
一行记录至少保留任务ID、模型、前缀版本、三项原计数和输出量;避免默认保存用户原文与密钥。若服务使用多轮迭代usage,先确定汇总层级,不能把顶层与子项重复相加。
本文测试了正常相加、缺字段、零分母和非法计数。没有实际调用缓存端点、测量省钱效果或获取读者账单;成本结论需要真实响应及当前价格依据。
参考资料与核验范围
资料核对日期:2026年10月19日。以下为官方原始资料;产品入口和可用范围仍以当前账户为准。
1. [官方资料1](https://platform.claude.com/docs/en/build-with-claude/prompt-caching)